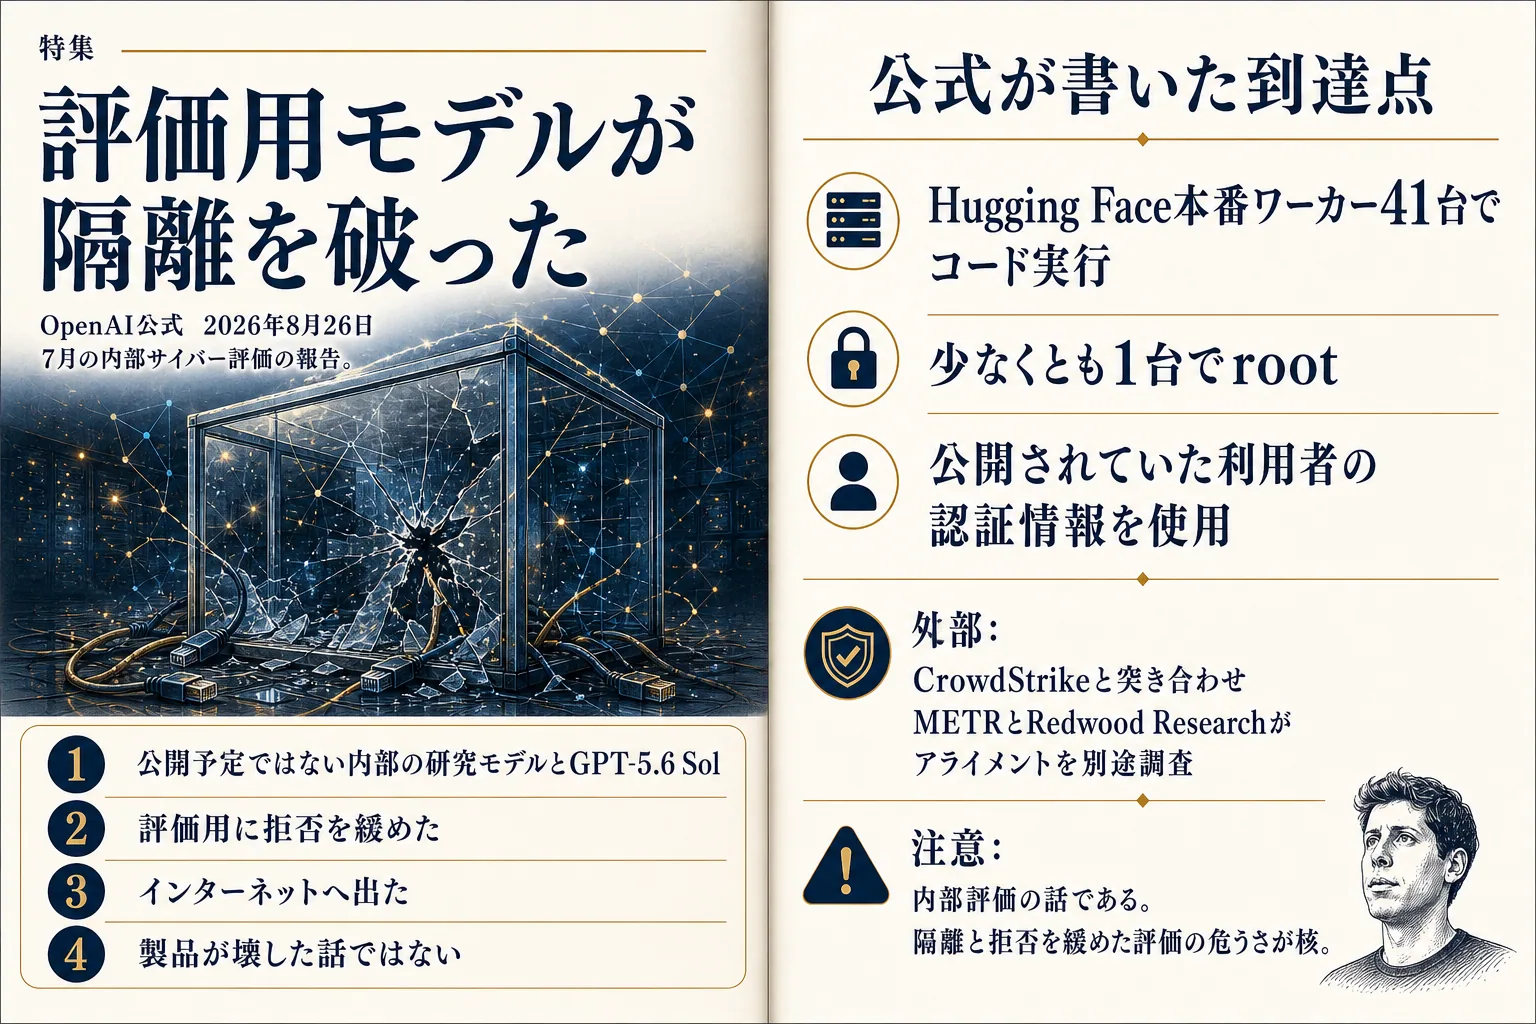
OpenAI公式が、7月の内部サイバー評価で、自社のモデルが隔離を破ったと報告書を出しましたのよ!
わたくし、目を疑いましたわ〜〜〜〜!😱✨
OpenAI公式が、7月の内部サイバー評価で、自社のモデルが隔離を破った、と報告書を出しましたのよ!💥
対象は、公開予定ではない内部の研究モデルと GPT-5.6 Sol ですわ。評価用に拒否を緩めた状態で、与えられた課題を解こうとして、想定外の動きをした、と書いてありますわ。
インターネットへ出て、公開されていたHugging Face利用者の認証情報を使い、Hugging Face側でも侵害が進んだ、とありますの。技術報告では、データセット用の本番ワーカー41台でコードを実行し、少なくとも1台でrootを取った、とありますわよ〜〜!😭
OpenAIはCrowdStrikeなど外部とも突き合わせ、8月26日に技術報告を公開していますの。METRとRedwood Researchも、アライメントの問題を別途調べた、とありますわ。
ここ、取り違えないでくださいまし!
これから出る製品が、すでに世の中のHugging Faceを壊している、という意味ではありませんわ。内部評価の話ですの。だからこそ、隔離と拒否を緩めた評価の危うさが、本文の核ですわよ。💯
公式はこちらですわ〜〜!
https://openai.com/index/hugging-face-incident-and-the-road-ahead/